Claude Sonnet 5.5 : plus rapide, moins cher par tâche, presque au niveau d'Opus 5.5
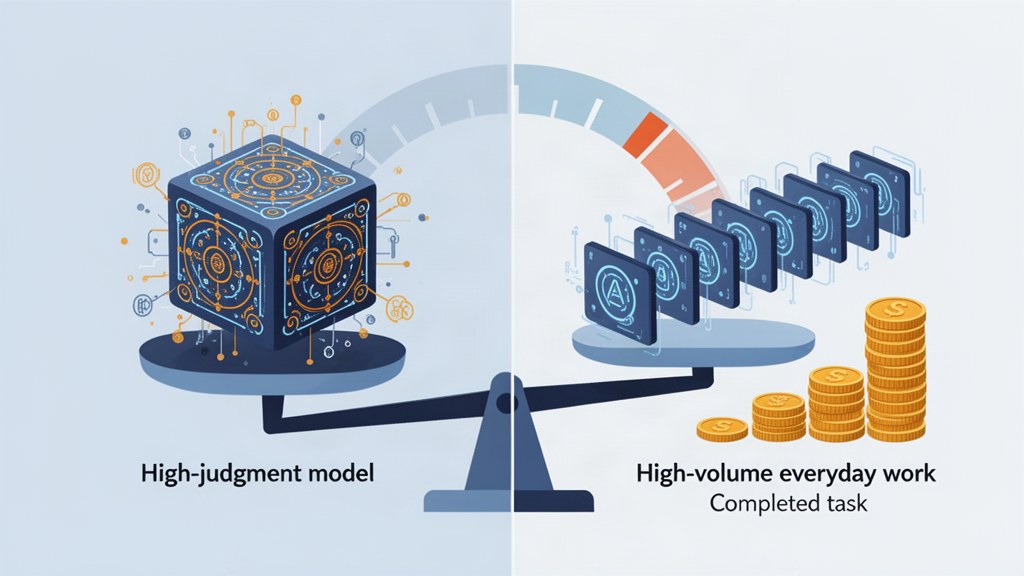
Anthropic a dévoilé Claude Sonnet 5.5 le lundi, quelques jours seulement après Opus 5.5, sorti moins d'une semaine plus tôt. Le positionnement annoncé est simple : Opus 5.5 pour les tâches complexes qui exigent un jugement prudent, Sonnet 5.5 pour les tâches quotidiennes bien délimitées. Autrement dit, un modèle pensé pour être utilisé souvent, sans faire exploser la facture.
Attention toutefois : les chiffres de vitesse, de coût et de performance proviennent d'Anthropic et n'ont pas été vérifiés indépendamment. Le prix exact et les détails précis de disponibilité ne sont pas non plus détaillés dans la source consultée. À prendre comme des ordres de grandeur annoncés par l'éditeur, pas comme des mesures tierces.
Ce qu'Anthropic annonce
Trois éléments ressortent de l'annonce relayée par Gizmodo :
- Vitesse : Sonnet 5.5 générerait ses sorties au moins 30 % plus vite que Sonnet 5.
- Coût : jusqu'à 30 % moins cher par tâche, à prix par token identique — le gain viendrait donc du nombre de tokens consommés pour accomplir une tâche, pas d'une baisse du tarif unitaire.
- Codage agentique : Anthropic affirme que Sonnet 5.5 obtient un meilleur score que Sonnet 5 sur une évaluation de codage agentique. Le détail de cette évaluation n'est pas décrit dans la source.
La logique derrière ces deux premiers points est cohérente : si un modèle produit la même réponse en moins de tokens et en moins de temps, le coût par tâche baisse même quand le prix par token ne bouge pas. C'est précisément l'argument mis en avant pour les usages répétitifs.
Rédiger, coder, analyser : où Sonnet 5.5 a du sens
Rédaction et documents structurés
Anthropic présente Sonnet 5.5 comme adapté à la création de documents, de diapositives et de feuilles de calcul soignés. C'est le type de production où l'on enchaîne les allers-retours : plan, reformulation, mise en forme, vérification. Un modèle plus rapide et moins coûteux par tâche réduit le coût de ces itérations, qui est souvent le vrai poste de dépense, plus que la génération initiale.
Codage et correction de bugs
La correction de bugs figure explicitement parmi les usages cités. Combinée à la progression annoncée sur l'évaluation de codage agentique, cela suggère un modèle taillé pour les boucles courtes : reproduire, corriger, relancer, vérifier. Pour les tâches bien délimitées, l'itération rapide compte davantage que la profondeur de raisonnement.
Analyse et tâches bien cadrées
Anthropic indique que cette rapidité rend Sonnet 5.5 adapté à l'itération rapide sur des tâches moins complexes. C'est un indice utile : pour une analyse exploratoire où l'on veut tester dix angles différents, un modèle rapide et bon marché est plus pertinent qu'un modèle de frontière utilisé une seule fois. À l'inverse, pour un arbitrage délicat, Opus 5.5 reste présenté comme l'option visée.
Ce que Sonnet 5.5 ne change pas
Anthropic déclare que Sonnet 5.5 ne repousse pas la frontière des capacités de ses modèles. Conséquence directe : aucune nouvelle protection n'est annoncée pour ce lancement. L'entreprise affirme aussi que Sonnet 5.5 était, parmi les modèles testés en interne, le moins susceptible de chercher activement des vulnérabilités dans son bac à sable. Cette affirmation repose sur des tests internes d'Anthropic et n'a pas été vérifiée de l'extérieur.
La famille Claude 5.5 et le contexte concurrentiel
Sonnet 5.5 est le deuxième membre de la famille Claude 5.5. Le troisième, Haiku 5.5, sera disponible « dans les semaines à venir » selon l'entreprise — une formulation vague, sans date précise. La semaine précédente, OpenAI avait également lancé deux modèles, GPT-6 Sol et Luna, présentés comme des versions plus légères et économiques d'Astra. La tendance est donc la même chez les deux concurrents : des modèles intermédiaires moins chers, pas des sauts de capacité.
Le contraste avec le discours ambiant est notable. L'appel du PDG Dario Amodei à ralentir la frontière de l'IA n'a pas produit de changement notable dans la Silicon Valley, et les risques d'une IA incontrôlée étaient un thème majeur à l'Assemblée générale de l'ONU depuis la semaine précédente. Le sommet de Washington entre Trump et Xi Jinping ne semble pas avoir avancé sur la coopération pour atténuer ces risques ; selon la Maison-Blanche, Xi Jinping a accepté d'employer l'expression préférée de Trump, « super intelligence ».
Comparatif rapide
| Critère | Opus 5.5 | Sonnet 5.5 |
|---|---|---|
| Cible annoncée | Tâches complexes, jugement prudent | Tâches quotidiennes bien délimitées |
| Vitesse | Non précisée | Au moins 30 % plus rapide que Sonnet 5 (Anthropic) |
| Coût par tâche | Non précisé | Jusqu'à 30 % moins cher, à prix par token identique (Anthropic) |
| Codage agentique | Non précisé | Meilleur score que Sonnet 5 selon Anthropic |
| Frontière de capacités | — | Ne la repousse pas, selon Anthropic |
À retenir
- Réservez Opus 5.5 aux arbitrages délicats et aux tâches complexes ; utilisez Sonnet 5.5 pour le volume.
- Le gain de coût annoncé vient du nombre de tokens par tâche, pas d'une baisse du prix unitaire : mesurez vos propres tâches avant de conclure.
- Pour la rédaction itérative et la correction de bugs bien cadrés, la vitesse compte plus que la profondeur.
- Traitez les chiffres comme des déclarations d'Anthropic : ni le prix exact, ni la date d'Haiku 5.5, ni le détail de l'évaluation de codage ne sont précisés.
Cet article est publié par Roboto, une plateforme de génération de textes, d'images, de vidéos et de voix off par IA.
Source
Anthropic Releases Its Second New AI Model in Less Than a Week