Google classe la relecture humaine « critique » pour les contenus IA : ce qui change pour vos métadonnées
Le 1er octobre 2026, Google a modifié sa page d'aide consacrée aux contenus générés par IA. Selon l'analyse publiée le 2 octobre par l'agence de Memphis HigherVisibility, cette révision est la première depuis un an et introduit un changement de vocabulaire qui mérite l'attention des créateurs francophones : la vérification factuelle et la relecture manuelle avant publication y sont désormais qualifiées de « critiques ». Mieux : la phrase qui suit précise que cette relecture s'applique aussi aux balises title, aux méta-descriptions, aux données structurées et aux textes alternatifs d'images.
Autrement dit, l'exigence ne porte plus seulement sur le corps d'un article ou d'une fiche produit, mais sur les métadonnées qui l'accompagnent. Pour quiconque publie du texte ou des images générés par IA, cela déplace le point de vigilance habituel.
Ce que dit exactement la révision
D'après HigherVisibility, qui dit avoir comparé la nouvelle version à une version archivée, la documentation ne change pas de nature : elle continue de présenter l'IA générative comme un outil utile pour la recherche et la structuration. La révision n'interdit pas le contenu IA et n'annonce aucune nouvelle sanction. Ce qui évolue, c'est le statut accordé à la relecture humaine : elle n'est plus un simple bon réflexe, elle est présentée comme une étape critique du processus éditorial.
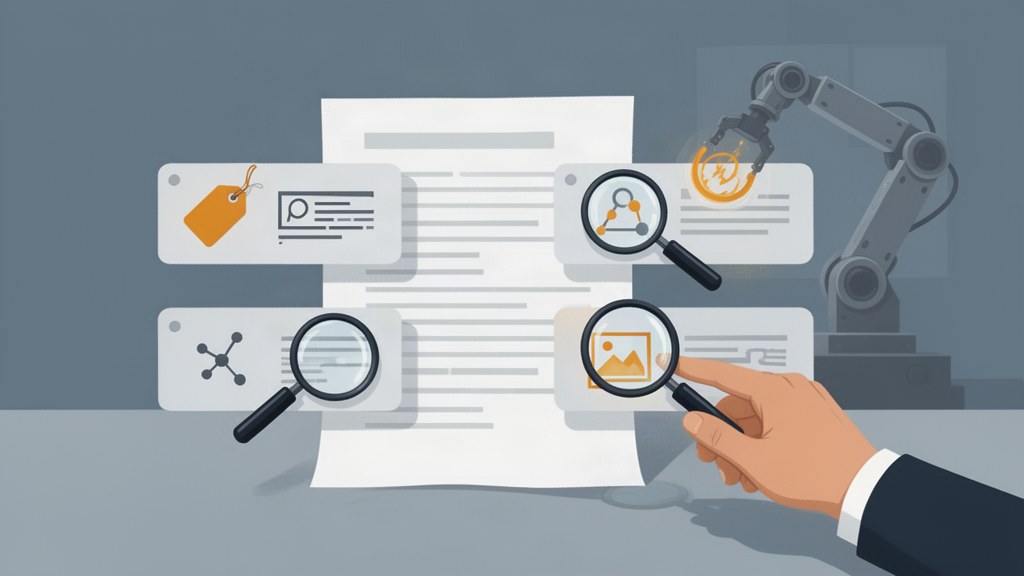
Le détail qui compte pour les équipes SEO et e-commerce, c'est l'extension explicite aux quatre surfaces de métadonnées :
- les balises title ;
- les méta-descriptions ;
- les données structurées ;
- les textes alternatifs d'images.
Ces quatre éléments sont précisément ceux que les catalogues e-commerce et les pipelines de contenu génèrent le plus souvent de façon automatique, à grande échelle. C'est là que le bât blesse : une relecture humaine « critique » devient difficile à tenir quand on produit des milliers de fiches par script.
Pourquoi le calendrier compte
La révision est intervenue le huitième jour de la mise à jour anti-spam de septembre 2026. Selon la source, Google a estimé cette mise à jour à « jusqu'à deux semaines », une première, alors que les trois mises à jour anti-spam précédentes de l'année se seraient terminées en moins de trois jours. Cette durée inhabituelle suggère un déploiement plus lourd, mais il faut rester prudent : ces éléments proviennent d'une analyse d'agence, pas d'une confirmation officielle de Google, et la comparaison des durées n'est pas vérifiable dans le texte fourni.
La même semaine, Google Research a publié un article décrivant SAFE, un système multi-agents d'investigation de contenu synthétique coordonné. Le lien entre cette publication et la révision de la documentation n'est pas établi par la source. Il serait abusif d'y voir une causalité ; on peut simplement noter que les deux sujets occupent le même terrain : la détection et la traçabilité du contenu synthétique.
Ce que la révision ne dit pas
Deux confusions circulent souvent et méritent d'être écartées.
Premièrement, l'obligation du Merchant Center d'étiqueter les images produit générées par IA avec des métadonnées IPTC ne fait pas partie de cette mise à jour. Selon l'analyse, cette clause existe depuis au moins mai 2025, sans changement, et reste largement non appliquée. Ne la présentez donc pas comme une nouveauté d'octobre 2026.
Deuxièmement, la révision ne crée pas de sanction spécifique au contenu IA. Les politiques anti-spam de Google continuent de cibler le contenu à grande échelle sans valeur ajoutée, quelle que soit sa méthode de production. Un texte généré par IA et soigneusement relu n'est pas visé ; un texte généré par IA et publié en masse sans contrôle l'est, comme l'aurait été un texte produit autrement dans les mêmes conditions.
Conséquences concrètes pour les créateurs francophones
La lecture la plus utile de cette révision est opérationnelle. Si la relecture humaine est « critique » et qu'elle couvre les métadonnées, alors vos contrôles qualité doivent porter aussi sur les champs que l'on délègue le plus volontiers à l'automatisation.
1. Échantillonner les titres générés
Les balises title produites en série sont rarement relues une par une. Un échantillonnage régulier permet de repérer les formulations creuses, les répétitions et les approximations factuelles avant qu'elles ne se propagent à tout un catalogue.
2. Détecter les méta-descriptions dupliquées
Quand un même gabarit alimente des milliers de pages, les méta-descriptions se ressemblent. Un contrôle de similarité aide à identifier les blocs qui n'apportent rien et qui trahissent une génération non supervisée.
3. Valider les données structurées
Les données structurées générées automatiquement peuvent décrire un produit ou un service de façon inexacte. Une validation, même par échantillon, limite le risque d'informations erronées présentées dans un format que les moteurs lisent facilement.
4. Relire les textes alternatifs d'images
Les alt d'images générés par IA sont souvent génériques ou faux. Or ils participent à l'accessibilité et à la compréhension d'une page. Une relecture ciblée sur les images importantes suffit souvent.
Un cadre, pas une interdiction
Il faut éviter deux excès symétriques. Le premier consiste à lire cette révision comme une interdiction du contenu IA : ce n'est pas ce que dit la documentation, qui continue d'en reconnaître l'utilité. Le second consiste à la balayer comme un simple ajustement de vocabulaire : qualifier une étape de « critique » et l'étendre explicitement aux métadonnées change la façon dont une équipe doit documenter ses processus.
La prudence reste de mise sur l'interprétation. L'analyse provient d'une agence de marketing, pas d'un test indépendant ni d'une confirmation de Google, et le contenu de la révision est rapporté via une comparaison avec une version archivée, non citée directement. Les faits rapportés sont cohérents, mais ils ne constituent pas une validation officielle.
À retenir
- Le 1er octobre 2026, Google a révisé sa page d'aide sur les contenus IA pour la première fois depuis un an, selon HigherVisibility.
- La vérification factuelle et la relecture manuelle avant publication y sont qualifiées de « critiques ».
- Cette relecture s'applique explicitement aux titres, méta-descriptions, données structurées et alt d'images.
- Aucune interdiction du contenu IA ni nouvelle sanction n'est annoncée.
- L'obligation IPTC du Merchant Center pour les images produit générées par IA est antérieure et distincte de cette mise à jour.
- Les politiques anti-spam visent le contenu à grande échelle sans valeur ajoutée, pas la méthode de production en soi.
Pour une équipe qui publie du contenu assisté par IA, la conclusion pratique tient en une phrase : intégrez les métadonnées à votre processus de relecture, pas seulement le corps de texte. C'est là que se logent les erreurs les plus discrètes et les plus faciles à propager.
Cet article est publié par Roboto, une plateforme de génération de textes, d'images, de vidéos et de voix off par IA. Roboto n'a réalisé aucun test sur ce sujet ; les observations rapportées ici proviennent de l'analyse de HigherVisibility relayée par PR Newswire.
Source
HigherVisibility Analysis: Google's AI Fact-Check Rule Now Covers Metadata